如何与 Claude Code 协同开发?—完整列出现行运作方式
Back to Top
为了覆盖更广泛的受众,这篇文章已从日语翻译而来。
您可以在这里找到原始版本。
引言
#最近,利用 Claude Code 的个人开发推进方式已经基本稳定成型。
因为多次反复重构,我认为当前的形式也是一个过渡阶段。不过,当被问到“你是如何与 Claude Code 一起开发的?”时,我想拿得出手,因此把目前的结构一一写了出来。
本文并非在提倡“应该这样构建”。纯粹是我目前的运作方式的记录。
本文结构
#本文结构如下。
- 整体概览:用一张图展示整个开发周期,并说明如何阅读
- 本项目的宪法:说明图中前提的三个规则,即“将什么写在哪里以备记录”、“如何强制执行”、“在哪些时点由人类判断”
- 【第一部分】一个功能完成前:按照
Plan → TDD → Review → Verify → Commit → CI实际的一个循环,结合四个 Gate,依次从左到右逐步追踪 - 【第二部分】把哪些信息放在哪里:说明在规则、技能、子代理和脚本等中写了什么,以及为什么放在那里
- 结语:说明当前形式是过渡点,以及尚未解答的课题
如果只想了解整体设计,只需阅读前两章;想了解实际运营流程,到第一部分为止;想深入了解资源的放置方式,请读到第二部分。
整体概览
#先看一张图。这就是目前正在运转的整体。
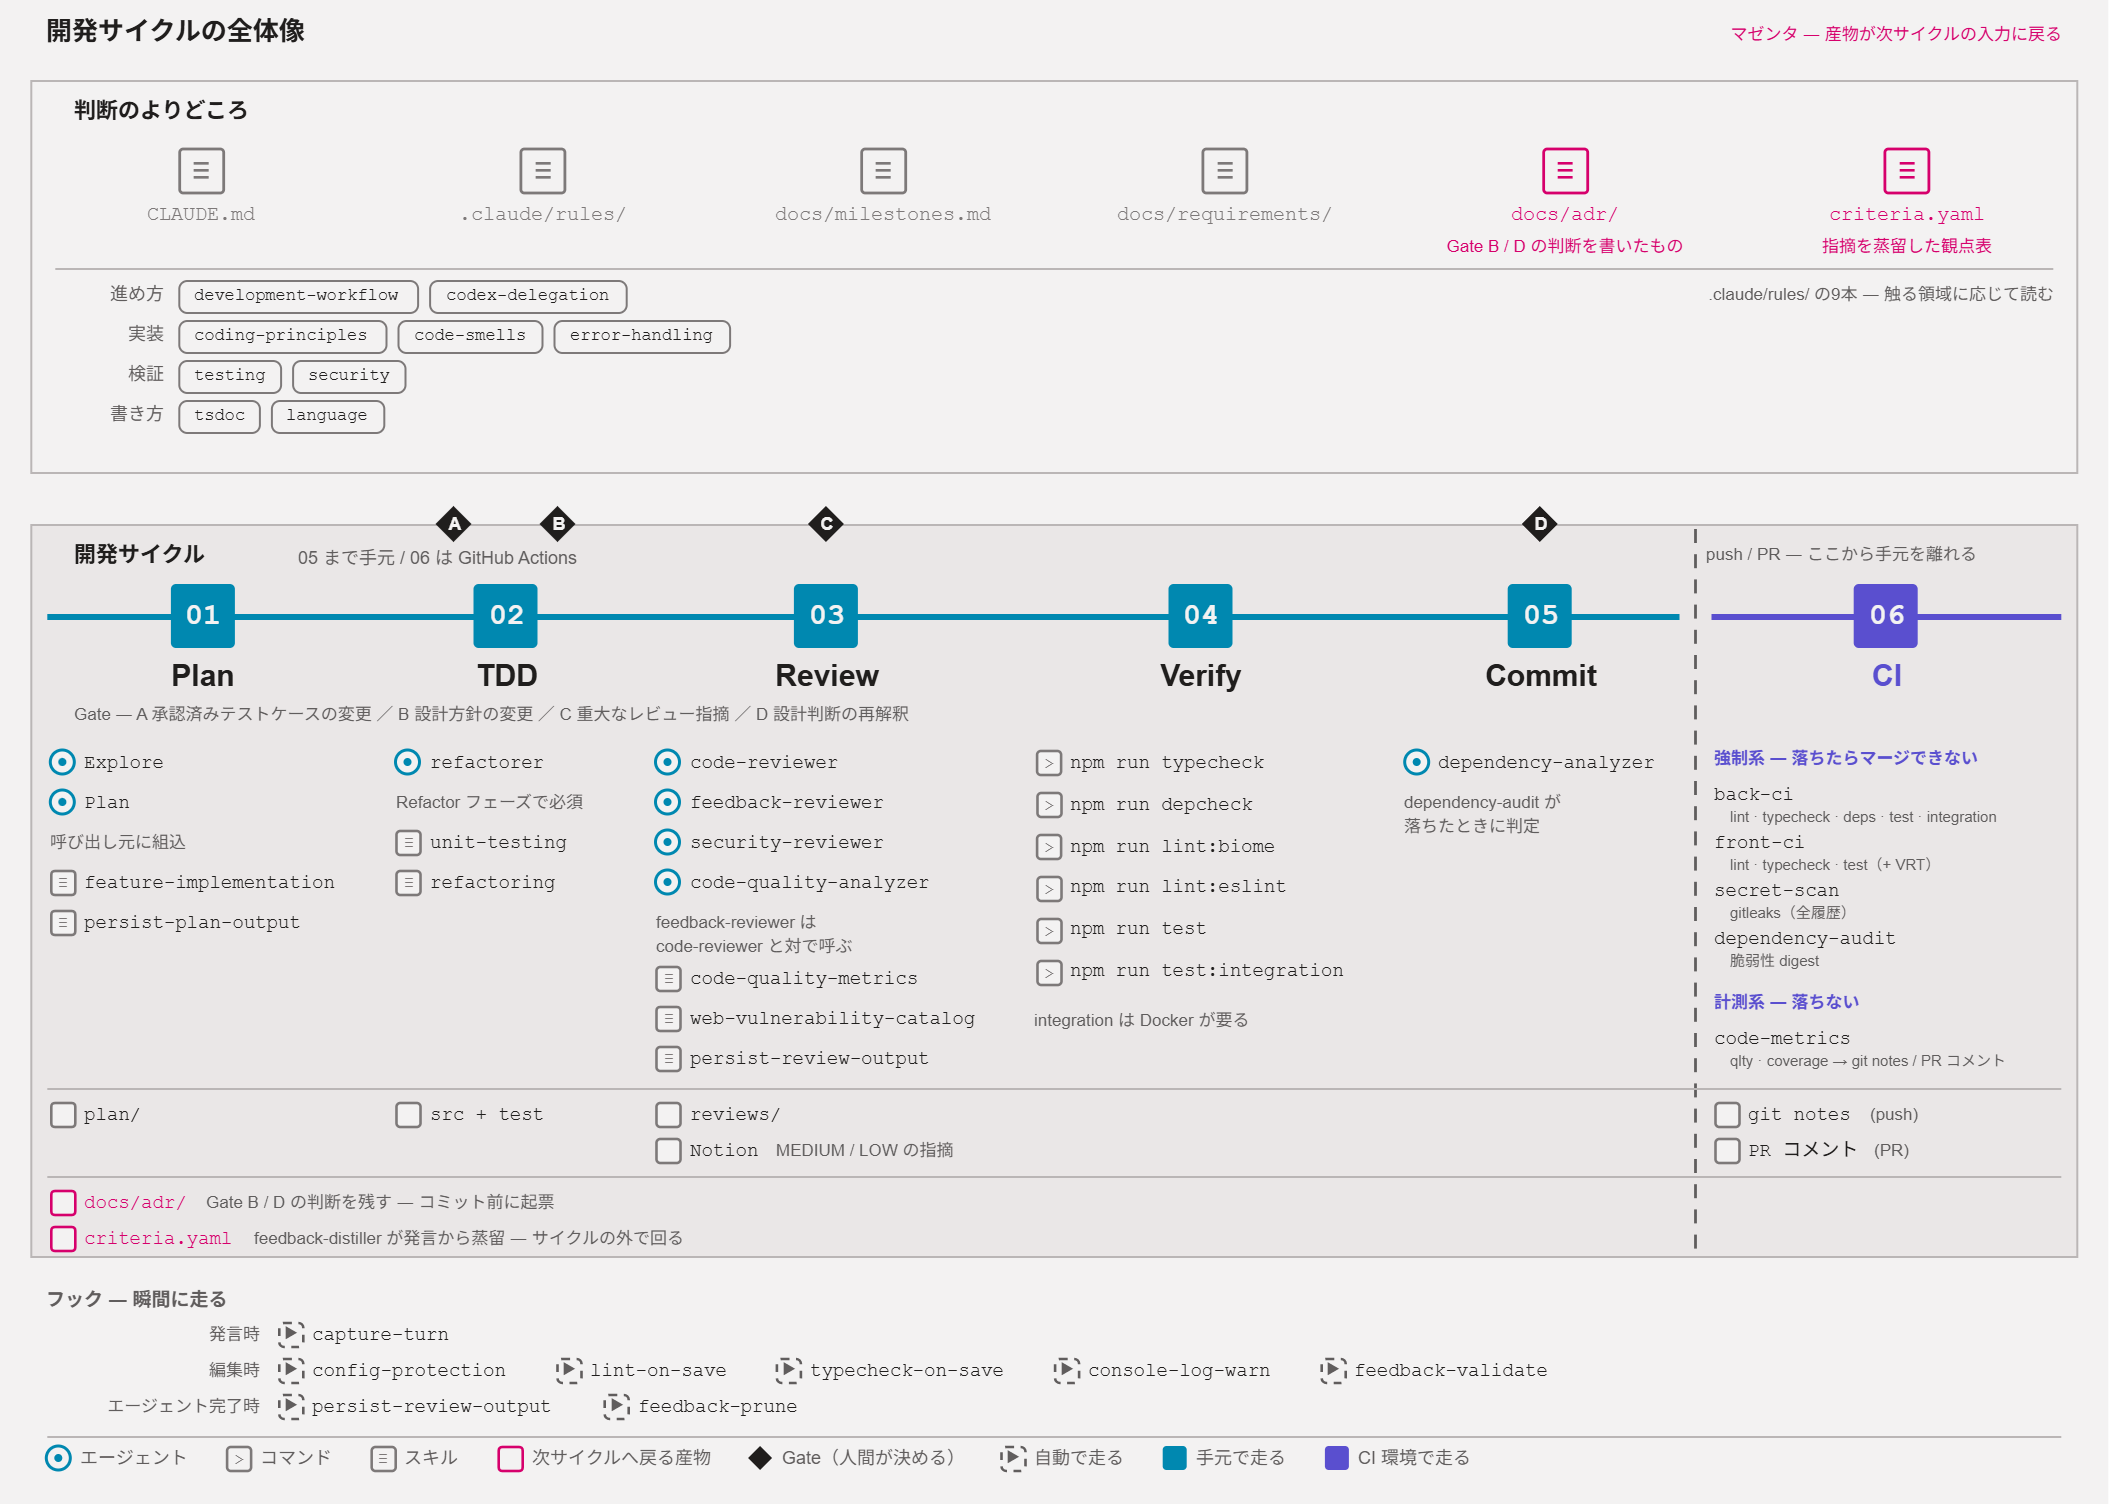
这张图的解读方法如下。
- 上方的框是材料。开发过程中人类和 Claude Code 会反复阅读的文档,诸如
docs/adr/、.claude/rules/等都列在这里 - 下方的框是执行。从
01 Plan到06 CI,时间从左向右流动05 Commit以前是在本地环境,06 CI及以后是 GitHub Actions。因为执行环境发生变化,用不同颜色并用虚线分隔- 黑色的菱形 A~D 是我做判断的节点
- 品红色的
docs/adr//criteria.yaml在上下各出现一次,但它们是同一个。判断和指摘会被记录,并重新作为下一个开发周期的材料
在本文中,将从左到右依次解读这张图,然后详细说明图中无法表现的部分。
本项目的宪法
#图中前提的有三条规则。
| 规则 | 概述 |
|---|---|
| 先确定归属,再留下记录 | 通过四阶段筛选,将要记录的内容分配到 ADR / 代码 / 设计文档 / 不写 |
| 不是写下来再强制执行,而是让违规根本写不出来 | 优先让类型无法表达违规情况 |
| 预先确定我做出判断的环节 | 在流程中固定四个需要我做判断的节点 |
先确定归属,再记录
#在实施过程中,会不断出现想要写在代码之外的内容:“为什么选择这种方式”“整体如何协同运作”“这个值的上限是多少”“部署流程如何运转”等等。
以前,我会把这些逐一添加到设计文档中。但结果是,当认证相关的设计文档超过 3000 行时,文档与代码的内容开始出现不一致。哪边是正确的也分不清。要修正时必须同时修复两处。渐渐地就不再查看设计文档了。
因此,一旦出现想记录的内容,就会先确定存放位置。按角色划分的媒介如下。
| 角色 | 媒介 |
|---|---|
| WHAT(要做什么) | 需求定义文档 |
| WHY(为什么这么做) | ADR |
| HOW(如何实现) | 源代码(类型、函数、zod schema) |
| VERIFY(是否正确构建) | 测试代码 |
| OVERVIEW(俯瞰与整合) | 设计文档 |
然而,仅凭此表无法决定。例如,“将错误处理统一在中间件中”既是做出该决策的理由(WHY),也是整体结构的一部分(OVERVIEW)。相同的内容既可以放入 ADR,也可以放入设计文档。
我将区分点设为:是截取单个决策,还是将整体结构整合到一张图。ADR 每做一个决策就会新增一个文件,所以目前已有 124 个。设计文档则如“整体构架”“部署步骤”这类,数量是固定的,决策增多时内容会随之更新。
“为什么选择这种方式”则放入 ADR,“整体如何协同运作”则放入设计文档。
在此基础上,对每条想要记录的内容,依次提出四个问题,将第一个回答 YES 的目标作为存放位置。
| 问题 | YES 的目标 |
|---|---|
| Q1. 这是一个“决策”吗?(存在替代方案/权衡) | ADR(每个决策一个文件) |
| Q2. 是可以通过阅读代码/类型/测试/OpenAPI 重新生成的事实吗? | 代码才是真正的源头,文档中只保留引用 |
| Q3. 每次代码变更时是否也会改变(易失性)? | 不写入文档。要么保留在代码中,要么从代码自动生成 |
| Q4. 是否稳定且从代码的单一位置无法察觉? | 属于设计文档的范畴 |
将最初举例的四项通过此表进行分配:“为什么选择这种方式”在 Q1 被分到 ADR;“这个值的上限是多少”在 Q2 被分到代码;“整体如何协同运作”和“部署如何运转”在 Q4 被分到设计文档。
通过这四个问题分配后,能存活到 Q4 的有以下四种类型。
- 集成概览(整体结构图)
- 跨域惯例(命名和日志项标准)
- 运行知识(部署步骤、runbook)
- 领域语言(术语汇编、上下文映射)
它们都是“数月内跨多个文件持续为真”且“仅阅读代码的某一处无法看到”的交叉领域。
因此,不编写详细设计文档。这里所指的详细设计文档,是瀑布模型中“详细设计”阶段的产物,即在编写代码前通过文档确定类结构、函数签名、字段定义、验证规则和处理顺序。签名和字段定义可以通过读取类型重新生成,因此在 Q2 阶段被排除;类结构和处理顺序会随着代码变更而改变,因此在 Q3 阶段被排除。
不是写下来再强制执行,而是让违规根本写不出来
#有多种手段可以让规约被遵守,但最优先的是“让类型无法表达违规”。不是在文档中写“请这样做”来强制执行,而是使违规本身无法发生。
实际中这样做的场景举两个例子。
通过类型和 lint 禁止伪造 ID
像用户 ID 这样的标识符,不用普通的 string,而是使用 branded type。
export const UserIdSchema = z
  .string()
  .min(1)
  .max(128)
  .regex(/^[A-Za-z0-9_-]+$/)
  .brand<"UserId">();

export type UserId = z.infer<typeof UserIdSchema>;

export const userId = (raw: string): UserId =>
  enforceInvariant(UserIdSchema, raw, "UserId");
由于 .brand<"UserId">() 的存在,将原始的 string 传给 UserId 类型的参数会导致编译错误。要创建 UserId 只能通过 userId(),在其中会进行长度和字符类型的验证。未通过验证的值在类型层面上无法存在。
但是,类型存在绕行方法。若使用 "anything" as UserId 强制转换,就能不经过验证而宣称为 UserId。因此,我使用 ESLint 封堵了这个漏洞。
// eslint.config.mjs
const noAsBrandedScalarVo = {
  selector:
    "TSAsExpression[typeAnnotation.typeName.name=/^(UserId|BudgetId|SpendingQuadrant|BudgetQuadrant)$/]",
  message:
    "对 branded scalar/枚举 VO 使用 as 强制转换是类型伪造的漏洞。只能通过 VO 的 factory 进行生成。",
};
一旦写了 as UserId 就会触发 lint。与其在文档中写“ID 请务必通过 userId() 创建”,我更是先用类型封堵,再用 lint 封堵类型的绕行。
让对照表的遗漏成为编译错误
我们使用了一些对照表,用于为以 literal union 定义的每个值绑定相应的值。
type Status = "todo" | "doing" | "done";

const STATUS_SLUG = {
  todo: "to-do",
  doing: "in-progress",
  done: "done",
} as const satisfies Record<Status, string>;
末尾的 satisfies Record<Status, string> 会在 union 未包含所有成员时触发类型错误。只要向 Status 新增一个成员,该表若未更新就会在构建时报错,无需在 review 中发现。
二者的共同点是,不需要人工确认是否遵守。一旦违反,就会被编译或 lint 拦截,不会流到 review 阶段。
预先确定我做判断的场景
#即便通过规约和类型约束,在实现过程中总会出现需要判断的场景。因此,我在流程中配置了四个需要我进行判断的环节。图中的黑色菱形 A~D 即是它们。
| Gate | 我需要判断的事项 |
|---|---|
| A | 是否修改已批准的测试用例 |
| B | 实现过程中如何修改已发现的设计方针 |
| C | 针对严重的 review 指摘,是立即修复还是延后 |
| D | 当现有 ADR 与实际代码不一致时如何解读 |
B 和 D 都要求在提交前编写 ADR。
ADR 中曾写道“通过 errorMiddleware 进行错误处理”,假设是在请求处理流程中插入中间件捕获处理器抛出的异常。但实际实现时,后端使用的 Hono 框架即便在中间件中使用 try/catch 也无法捕获处理器的异常,因为框架会在内部自行处理异常。要捕获异常,需要使用 Hono 提供的另一种注册入口 app.onError()。
此时也可以将 ADR 中的“errorMiddleware”解读为“指 app.onError”,然后继续。但那样会导致 ADR 中保留一个在实现中并不存在的机制。于是我编写了新的 ADR,记录这一技术限制,并加入“今后应将‘errorMiddleware’解读为 app.onError 的 handler”这一解读,同时保留原 ADR 的正文未作修改。
1. 规划
#本章将追踪在创建一个功能时,前章提到的三条规则如何发挥作用。以图下方的框从左到右的顺序,逐个阐述各流程中“做了什么,在何处会中断”。
Plan → TDD → Review → Verify → Commit → CI
       A B     C                 D
图中链条下的 A~D 就是 Gate 的位置。TDD 阶段有两次,Review 和 Commit 阶段各有一次需要我做出判断。
各流程的操作步骤汇总在 feature-implementation 技能中,Claude Code 会在编写第一个文件前读取它。
2. 从测试入手
#测试的编写方式写在规则文件 testing.md 中,代理会据此执行。
Always follow a two-phase approach: define test cases → review → implement. Never implement tests before the user approves the test case list.
首先仅编写空的测试用例,然后提交给我审核。实际的提示大致如下。
describe("BudgetAmount", () => {
  // 正常情况
  test("可以从正整数生成", () => {});
  test("等于上限值时可以生成", () => {});

  // 异常情况
  test("小于等于 0 时无法生成", () => {});
  test("超过上限时无法生成", () => {});
  test("包含小数时无法生成", () => {});

  // 边界
  test("上限 + 1 时无法生成", () => {});
});
内容是空的,仅有 test 的说明文本。代理会询问“这个视角是否正确?”。
若要修改此处批准的测试用例,需获得我的同意。这就是 Gate A。当允许无须批准就改动时,就会出现将测试不通过的原因归结为框架因素,从而逐个删除测试用例的情况。因此,对于已批准的测试用例的更改,会要求同时附上理由说明并予以拦截。
在 Green 之后,会调用 refactorer 代理。它会阅读 Claude Code 实现的代码,检测代码异味并执行重构。听闻代码作者本身不易察觉自身代码问题,因此在实现完毕后,让另一个代理进行审视。
3. 提交审核
#针对不同观点评审分配了不同的代理。
| 代理 | 调用条件 |
|---|---|
code-reviewer |
修改文件 ≥ 3 个或更改行数 ≥ 100 行 |
feedback-reviewer |
每当调用 code-reviewer 时必定一同调用 |
security-reviewer |
涉及认证/授权/API/用户输入/敏感数据/数据库查询/文件上传/支付/日志输出/错误处理 时 |
code-quality-analyzer |
修改文件 ≥ 5 个或更改行数 ≥ 300 行,或 code-reviewer 提示结构性担忧 时 |
feedback-reviewer 的职责有所不同。它不是关注代码的一般质量,而是根据我过去提出的观点评价差异。观点评来源将在第二部分说明。
这些代理的审核结果会被自动保存。当审核类代理完成时,PostToolUse 钩子会触发,并由 persist-review-output.py 将输出全文写入 .claude/docs/reviews/。
其中 MEDIUM/LOW 级别的问题会记入 Notion 的 backlog,HIGH/CRITICAL 则在下一个 Gate C 中处理。
Gate ― 人工判断节点
#将前章提到的四个 Gate 在什么环节触发做一张总结表。
| Gate | 触发环节 | 触发条件 | 我的决策 |
|---|---|---|---|
| A | TDD | 试图更改已批准的测试用例 | 是否允许更改 |
| B | TDD | 实现中需要变更设计方针 | 是否变更方针;若变更,需要先编写 ADR 再继续 |
| C | Review | 审核报告了 HIGH / CRITICAL 级别问题 | 立即修复 / 附上理由后延后 / 接受风险 |
| D | Commit 前 | 已写代码与现有 ADR 不一致 | 确定解读,并在提交前编写 ADR |
B 和 D 都要求在提交前编写 ADR。
ADR 中曾写道“通过 errorMiddleware 进行错误处理”,假设是在请求处理流程中插入中间件捕获处理器抛出的异常。但实际实现时,后端使用的 Hono 框架即便在中间件中使用 try/catch 也无法捕获处理器的异常,因为框架会在内部自行处理异常。要捕获异常,需要使用 Hono 提供的另一种注册入口 app.onError()。
此时也可以将 ADR 中的“errorMiddleware”解读为“指 app.onError”,然后继续。但那样会导致 ADR 中保留一个在实现中并不存在的机制。于是我编写了新的 ADR,记录这一技术限制,并加入“今后应将‘errorMiddleware’解读为 app.onError 的 handler”这一解读,同时保留原 ADR 的正文未作修改。
4. 验证
#在提交前,在代理操作过的包上运行以下四项检查。
npm run typecheck
npm run depcheck
npm run lint:biome
npm run lint:eslint
npm run test
npm run test:integration
这里正是宪法第二条所述机制实际触发的环节。as UserId 的强制转换会在 lint 阶段报错,对照表的遗漏会在 typecheck 阶段报错。即使代理忽略了规约,也会在此阶段被阻止。
5. 提交
#提交并非一个功能只提交一次,而是在每个阶段结束时进行提交。通过执行 /commit 来生成符合 Conventional Commits 格式的提交信息。
如果在 Gate B / D 阶段发生了设计决策的变更,需要确保在包含该决策的提交之前编写相应的 ADR。图中在 docs/adr/ 标注为“提交前起草”正是基于此。ADR 并非提交的产物,而是提交的前提条件。
6. 推送并传给 CI
#此时执行环境发生变化,即图中颜色变化的区域。
CI 将任务分为“失败则无法合并”和“失败也可合并”两类。
| 系统 | Workflow | 内容 | 行为 |
|---|---|---|---|
| 强制类 | back-ci |
lint / typecheck / 依赖检验 / 单元测试 / 集成测试 | 失败则阻断合并 |
front-ci |
lint / typecheck / 测试(含 VRT) | 失败则阻断合并 | |
secret-scan |
对所有历史记录进行 gitleaks 秘密信息扫描 | 失败则阻断合并 | |
dependency-audit |
检测依赖的漏洞遗漏与过时判断 | 失败则阻断合并 | |
| 统计类 | code-metrics |
qlty 指标 / 覆盖率 | 不阻断合并。将结果存入 git notes,并在 PR 中添加差异评论 |
当 dependency-audit 失败时,会在本地环境调用 dependency-analyzer 代理。它是一个子代理,用于判断两个无法由机器决定的问题:脆弱函数是否会被实际调用,以及是否可以接受该脆弱性。
在流程间自动执行的事项 ― 钩子
#除了上述流程,还有一些在特定时刻自动运行的机制。
| 时刻 | 钩子 | 操作内容 |
|---|---|---|
| 我发言时 | capture-turn |
将发言逐字索引记录(在第二部分使用) |
| 文件被编辑时 | config-protection |
阻止对 lint/formatter 配置文件的编辑 |
lint-on-save / typecheck-on-save |
格式化并进行类型检查所编辑的文件 | |
console-log-warn |
警告残留的 console.log |
|
feedback-validate |
检测对观点评审表的手动编辑(参见第二部分) | |
| 代理完成时 | persist-review-output |
保存审核输出 |
feedback-prune |
将不再使用的观点评审项从表中移除(参见第二部分) |
这是在特定时刻自动触发的机制,而非代理自己决定时机再去执行。
顺便提到,只有 config-protection 性质不同。其他钩子是用于记录或格式化,而它则直接阻止编辑。因为放宽 lint 配置就能消除规约违规,因此一开始就禁止该操作。
【第二部分】将何种信息放在哪里
#到此为止涵盖了开头那张图的范围。图中展示了“有什么”。从这里开始,将对各项目写了什么,以及为何放在此处进行说明。
Claude Code 能持续读取的内容量是有限的。如果把所有内容都写入 CLAUDE.md 或规则,单是在读取就会填满上下文,使得关键指令被淹没。因此,根据信息应何时被读取来划分存放位置。
| 存放位置 | 读取时机 | 存放内容 |
|---|---|---|
CLAUDE.md / .claude/rules/ |
始终 | 索引、始终生效的约束和事实 |
.claude/skills/ |
仅在相关操作时 | 步骤、项目特定的方法论 |
| lint / 依赖检测 | 机器始终 | 要求遵守的规约 |
docs/ |
仅在通过索引查阅时 | ADR、设计文档、需求、里程碑、技术笔记 |
.claude/agents/ |
被调用时 | 角色、不可变条件、输出格式 |
| 脚本 | 代理读取结果时 | 计算 |
criteria.yaml |
审核时 | 我过去的指摘 |
钩子也是一种存放位置,但已在第一部分说明,此处略去。
宪法第一条中,提出了将想记录的内容分配到 ADR/代码/设计文档/不记录的四个问题。对于面向 Claude Code 的资料,也适用了相同的问题。因此,能从代码或类型重构出的内容不予记录;每次随代码变动的内容也不记录。
始终生效的 ― CLAUDE.md 与 .claude/rules/
#CLAUDE.md 长度为 149 行,其核心是第一部分中提到的“涉及领域 → 必读 ADR”索引。并不写入 ADR 的内容,只保留如何引用的方式。此外,还写有生产环境和机密所在等任何操作都不能越过的边界。
而在 .claude/rules/ 中共有 9 个文件,每个文件行数在 16~75 行之间。
| 文件名 | 包含内容 |
|---|---|
development-workflow.md |
工作流程顺序及适用于所有环节的约束 |
coding-principles.md |
如强制返回类型注解等,适用于所有文件的原则 |
code-smells.md |
在过去审核中被频繁指出的 7 种代码异味 |
error-handling.md |
允许通过异常抛出错误的 5 种场景(其余场景一律通过返回值处理) |
security.md |
如资源所有者验证等,编写代码时需始终遵守的安全防护措施 |
testing.md |
生产代码侧的禁止事项与测试环境的事实 |
tsdoc.md |
关于注释写法中,仅模仿现有代码无法覆盖的事项(如不在 ADR 文档中编写内部标记等) |
language.md |
标识符、字符串、注释应使用何种语言 |
codex-delegation.md |
可向 Codex 咨询的条件(最近几乎未使用) |
规则中放置以下三类内容:
- 事实
- 禁止事项
- 通向真正源头的路径提示
其他内容不写入规则,而是放在各自的存放位置。
| 不写入规则的内容 | 存放位置 | 示例 |
|---|---|---|
| 步骤 | 技能 | 流程推进方式(feature-implementation) |
| 已写入 ADR 的内容 | ADR | 按层级划分的复杂度阈值 |
| 可通过阅读代码获知的内容 | 实际代码(真正源头) | 错误类型的创建方式、注释格式 |
对于将代码视作真正源头的内容,会让 Claude Code 仿照附近的文件编写。
仅在相关操作时加载 ― .claude/skills/
#技能仅在符合其说明中所描述的操作时加载。它不会始终加载,因此适合放置那些较长的步骤说明。
内容可分为两类。
| 类型 | 描述内容 | 主要使用方 | 示例 |
|---|---|---|---|
| 手顺 | “该操作每次都按此方式进行”的流程 | Claude Code 本体 | feature-implementation / persist-plan-output / persist-review-output / notion-taskextract-learning / consulting-codex / observe-metrics |
| 方法论 | 针对本项目覆盖的一般性理论部分 | 子代理 | refactoring / unit-testing / web-vulnerability-catalog |
规则与技能该放哪里
#有时会犹豫某项规定到底写入规则还是技能中。例如,关于测试的规定似乎更自然地放在测试技能里。然而,由于二者被 Claude Code 加载的时机不同,如果存放位置选择错误,Claude Code 就无法在需要时读取。
| 类型 | 加载时机 | 示例 |
|---|---|---|
| 规则 | 无论进行何种操作都始终 | testing.md |
| 技能 | 仅在符合技能说明中所描述的操作时 | unit-testing(仅在编写测试时) |
因此,通过以下三个问题决定放在何处。
- 如果模仿附近的文件就能写出相同内容? → 能写则两处都不写
- 该规定被违反时是否正处于技能加载的操作中? → 若否,则放在规则
- 即使被违反,也能通过测试或 lint 发现吗? → 若不能发现,则放在规则
例如,将两条与测试相关的规定代入上述问题,结果如下。
| 规定 | 何时会被违反 | 测试技能是否加载 | 存放位置 |
|---|---|---|---|
| 不在生产代码中添加为了测试而临时分支 | 在编写生产代码时 | 未加载 | 规则(testing.md) |
| 不在断言中使用错误消息文本 | 在编写测试时 | 已加载 | 技能(unit-testing) |
虽然两者都是与测试相关的规定,但存放位置不同。“不在生产代码中添加为了测试而临时分支”会在编写生产代码时被违反,此时测试技能并未加载,即使写在技能里,Claude Code 也无法读取。因此将其放入规则。
不写在文档中,而交给检查执行
#可以通过 lint 或依赖检测发现的问题不写入文档,而是以检查配置的方式管理。这是将宪法第二条中的“让违规无法书写”扩展到无法用类型表达的情况。
依赖方向 ― dependency-cruiser(15 条规则)
| 规则 | 禁止项 |
|---|---|
domain-no-infrastructure |
禁止 Domain 依赖 Infrastructure |
application-no-infrastructure |
禁止 Application 依赖 Infrastructure |
hono-only-in-interface-http |
禁止在 HTTP 层以外使用 Hono |
no-cross-context-domain |
禁止跨上下文引用 Domain |
另外还有循环依赖、孤立文件、Port 层的依赖约束等,共计 15 条。将 ADR 0002 中确定的分层结构直接落地为规则。
返回值类型 ― 自定义 ESLint 规则
该规则检查 UseCase 和 Port(Repository 接口)的返回值类型是否为 Result。由于现有 ESLint 规则中没有将返回值类型限定为特定类型的能力,所以自己编写了这条规则。
无论是依赖方向检查还是返回值类型检查,违规代码都会在检查时被拦截。此时不管 Claude Code 是否加载了规约或技能,使其被阻止即可。因此无需在规则文件中重复编写相同的规定。
通过索引查阅的 ― docs/
#docs/ 不会被 Claude Code 始终读取,而是在需要时通过 CLAUDE.md 中的索引进行查阅。其内容分为五类。
| 存放位置 | 内容 | 从何处查阅 |
|---|---|---|
docs/adr/ |
决策记录 | 索引中的“涉及领域 → 必读 ADR” |
docs/design/ |
设计文档(整体结构、部署步骤等) | 同一索引下的“相关设计文档” |
docs/requirements/ |
需求定义文档 | 在确认要做什么时 |
docs/milestones.md |
阶段定义与进度 | 索引中的“Phase 的当前位置” |
docs/learning/ |
技术学习笔记 | 在代理定义或技能直接引用时 |
ADR 与设计文档里写什么如同宪法第一条所述。这里将介绍 docs/learning/。
docs/learning/ 最初是用来存放我在与 Claude Code 协作过程中理解到的技术机制,以便后续回顾的学习笔记。其中,Fowler 的重构目录会被 refactorer 代理在确认异味或手法名称时引用。因 Claude 本身已将异味名称与手法步骤作为一般知识预置,因此并不每次都让其读取,只在名称或步骤未出现时才打开阅读。
在方法论中,作为一般理论适用的部分,如下借鉴自相关书籍。其存放位置为学习笔记或技能,出处如下。
| 知识 | 出处 |
|---|---|
docs/learning/refactoring-smells-and-techniques.md |
Martin Fowler『リファクタリング(第2版): 既存のコードを安全に改善する』オーム社 |
unit-testing |
Vladimir Khorikov『単体テストの考え方/使い方』 |
web-vulnerability-catalog |
IPA「安全なウェブサイトの作り方 改订第7版」(2021-03-31) |
仅在被调用时生效 ― 子代理
#此处所指的代理是指从 Claude Code 本体调用的其他代理(子代理)。本项目中定义的如下:
| 代理 | 职责 | 参考的方法论 |
|---|---|---|
code-reviewer |
质量、类型安全性和可维护性 | unit-testing / code-quality-metrics / refactoring |
feedback-reviewer |
针对我过去提出的观点评审 | criteria.yaml(观点评审表) |
security-reviewer |
漏洞检测 | web-vulnerability-catalog |
code-quality-analyzer |
定量分析与优先级排序 | scripts/metrics-digest.py(指标脚本) |
refactorer |
不改变行为的结构性改进 | refactoring / simplify / docs/learning/ 的目录 |
dependency-analyzer |
判断依赖漏洞的可达性与可接受性 | 读取 scripts/audit-digest.mjs 的输出 |
如最右列所示,代理定义本身并未写入方法论。例如 refactorer 的定义开头即为:
异味的分类与手法步骤为一般知识与
docs/learning/refactoring-smells-and-techniques.md,该一般理论在本项目不适用的部分由refactoring技能持有。
在代理定义中放的是“角色”、“流程步骤”以及“禁止事项”,具体的操作知识则拆分到技能和目录中。何时调用(如修改多少文件时调用)也仅写在各代理的 description 中,未重复写入规则。
示例① ― code-reviewer 在查看哪些内容后做判断
code-reviewer 在审核过程中会参考多种存放位置。在代理定义中,为各类判断制定了对应的参考来源表。
| 判断对象 | 参考位置 |
|---|---|
| 函数或文件的复杂度阈值 | ADR(按层级划分的阈值) |
| 错误处理方式(异常或返回值) | ADR |
| 不在日志或错误消息中泄露个人信息 | 规则(security.md) |
| 注释写法 | 附近文件的实际实例和规则(tsdoc.md) |
在此基础上,还确定了两点引用方式:
- 对于阈值等数值,不将其抄写到代理定义中,而是引用其出处。若抄写,在更新 ADR 时可能无法同步。
- 若引用来源之间存在不一致,则按 ADR → 代码注释 → 规则 的顺序优先。
子代理所使用的技能则根据需要随时加载。
| 技能 | 加载条件 |
|---|---|
unit-testing |
差异中包含测试文件 |
code-quality-metrics |
需要数值支持的指摘 |
refactoring |
在撰写重大指摘的修复建议之前 |
相反,由 lint 全量检测的内容(例如 any 的使用、未使用 import 等)已从手动检查清单中剔除,划分为交由机器执行的类别,而非人工查阅。
示例② ― dependency-analyzer 不承担哪些工作
这是在 CI 的 dependency-audit 失败时调用的代理。在其定义开头写道:
你的职责不是 检测 漏洞。漏洞检测及可由机器推导出的解读(依赖路径、dev/prod、CVSS 分解、修复手段)已由
scripts/audit-digest.mjs完成。你只需承担 digest 本质上无法回答的两点。
漏洞检测和机器可给出的信息(从哪个依赖进入、本番是否包含、如何修复)由脚本先行输出。代理承担以下两点:
- 可达性 — 从本代码库中是否能实际调用到脆弱函数
- 接受与否 — 选择修复、接受还是延后
可达性按以下顺序进行检查:
- 查看该依赖的起点是开发依赖还是生产依赖
- 若为生产依赖,则通过 grep 检查自身代码是否直接使用了该依赖
- 阅读自身代码是否会经过被列为脆弱的功能。例如,对于“Hono 的 CORS 中间件存在 ReDoS”,就需确认是否使用了 CORS 中间件
同时,不直接将漏洞严重度(severity)作为优先级来处理。
此外,代理定义中还列出了不做的事项:
- 不自行重新计算脚本输出
- 不向判定台账中自行写入;仅返回可粘贴的文本
- 对于可修复项,不检查可达性,直接修复即可
示例①②中所述内容是写在代理定义里的指导。并非通过钩子等强制执行,因此从技术上来说,dependency-analyzer 仍可向台账中写入内容。
不让代理计算的事项 ― 脚本
#将计算或由机器可得的信息留给脚本执行,而不让代理去计算。例如,code-quality-analyzer 读取 scripts/metrics-digest.py 的结果;dependency-analyzer 读取 scripts/audit-digest.mjs 输出的漏洞列表。
之所以交由脚本处理,是因为可以在编写测试后自动验证其输出是否正确。脚本负责产出数值,代理仅负责判断这些数值的含义,实现分工。
存储我过去指摘的 ― 观点评审表
#在第一部分中 Review 阶段,feedback-reviewer 所参照的“观点评”存放在 .claude/feedback/criteria.yaml 这个观点评审表里。表中内容是我过去对代理提出的指摘以模式化的形式提炼而成。例如,一项条目如下:
- id: corrections:260816-115935-1
  pattern: 在更改术语、数值、命令或步骤时,未将相同内容传播到其他资源(其他 ADR / plan / CLAUDE.md / rules / 配置文件),而是保留旧描述后再提出
  scope: docs/**/*.md, .claude/**/*.md, CLAUDE.md
  detection_hint: 对差异中替换的术语、数值、命令字符串使用 rg 在仓库全局搜索,并比对命中的其他文件是否包含相同差异
  occurrence: 10
从我的发言变为观点评审表条目、被审核使用,到任务结束并移除的流程如下:
capture-turn钩子将我的发言逐字索引记录feedback-distiller代理读取积累的发言,从中抽取需纠正的内容,并与现有条目进行分类比对- 向我展示晋级候选项,仅将我批准的部分写入观点评审表
feedback-reviewer在 Review 阶段将代码差异与观点评审表进行对照- 对多次对照仍未发现违规的条目,由
feedback-prune钩子从表中移除
此提炼流程不在开发周期内执行。只有在会话开始时,若 feedback-nudge 钩子通知存在未提炼的发言时,才统一执行提炼。
如果说 ADR 或规约是用于记录“已决定事项”的机制,那么这个是用于记录“已说却未被执行事项”的机制。
结语
#如在引言所述,我认为此形式也是一个过渡阶段。实际上,第一部分中提到的 Gate 在我撰写本文期间已做了重新审视。因为每次 Gate 都需等待我做判断,导致一个任务多次暂停。本文中仍以审视前的形式进行描述。
还有一些尚未有答案的问题。
- 我成为了任务的瓶颈:当前为了学习,也阅读所有成果物,因此任务会在我这里停留。
- 缺乏团队开发时的机制:迄今为止的机制是基于我一个人开发而构建的。我觉得在多人协作开发场景下的机制尚未完善。
- 从需求到实现未形成闭环:本文所述的是需求确定后的开发流程。在上游层面,将客户需求整理为开发需求、并串联到设计与实现的机制,我也认为尚未完善。
这些都不是能立即得到答案的课题,今后我会继续在试错中,逐步完善。