どうやって Claude Code と開発してる? ― いまの回し方をまるごと書き出してみた
Back to Top
はじめに
#Claude Code を利用した個人開発の進め方が、最近一定の形に落ち着いてきました。
何度も作り変えてきたので、いまの形も通過点だと思います。それでも「どうやって Claude Code と開発してるんですか?」と聞かれたときに渡せるものとして、現状の構造をひととおり書き出しておきます。
この記事は「こう作るべき」という提案ではありません。あくまで、ぼくはこう回しているという記録です。
この記事の構成
#本記事の構成は以下の通りです。
- 全体像:開発サイクル全体を1枚の図で示し、読み方を説明します
- このプロジェクトの憲法:図の前提になっている「何をどこに書き残すか」「どう守らせるか」「どこで人間が判断するか」という3つのルールを説明します
- 【第1部】1つの機能ができるまで:
Plan → TDD → Review → Verify → Commit → CIという実際の1サイクルを、4つの Gate と合わせて左から順に追います - 【第2部】どの情報を、どこに置いているか:ルール・スキル・サブエージェント・スクリプトなどに何を書き、なぜそこに置いたのかを書きます
- おわりに:いまの形が通過点であることと、まだ答えが出ていない課題を書きます
全体の設計だけ知りたければ最初の2章、実際の運用フローまで知りたければ第1部まで、資材の置き方まで踏み込みたければ第2部まで読んでもらえれば幸いです。
全体像
#まず1枚で。これがいま回っているものの全体です。
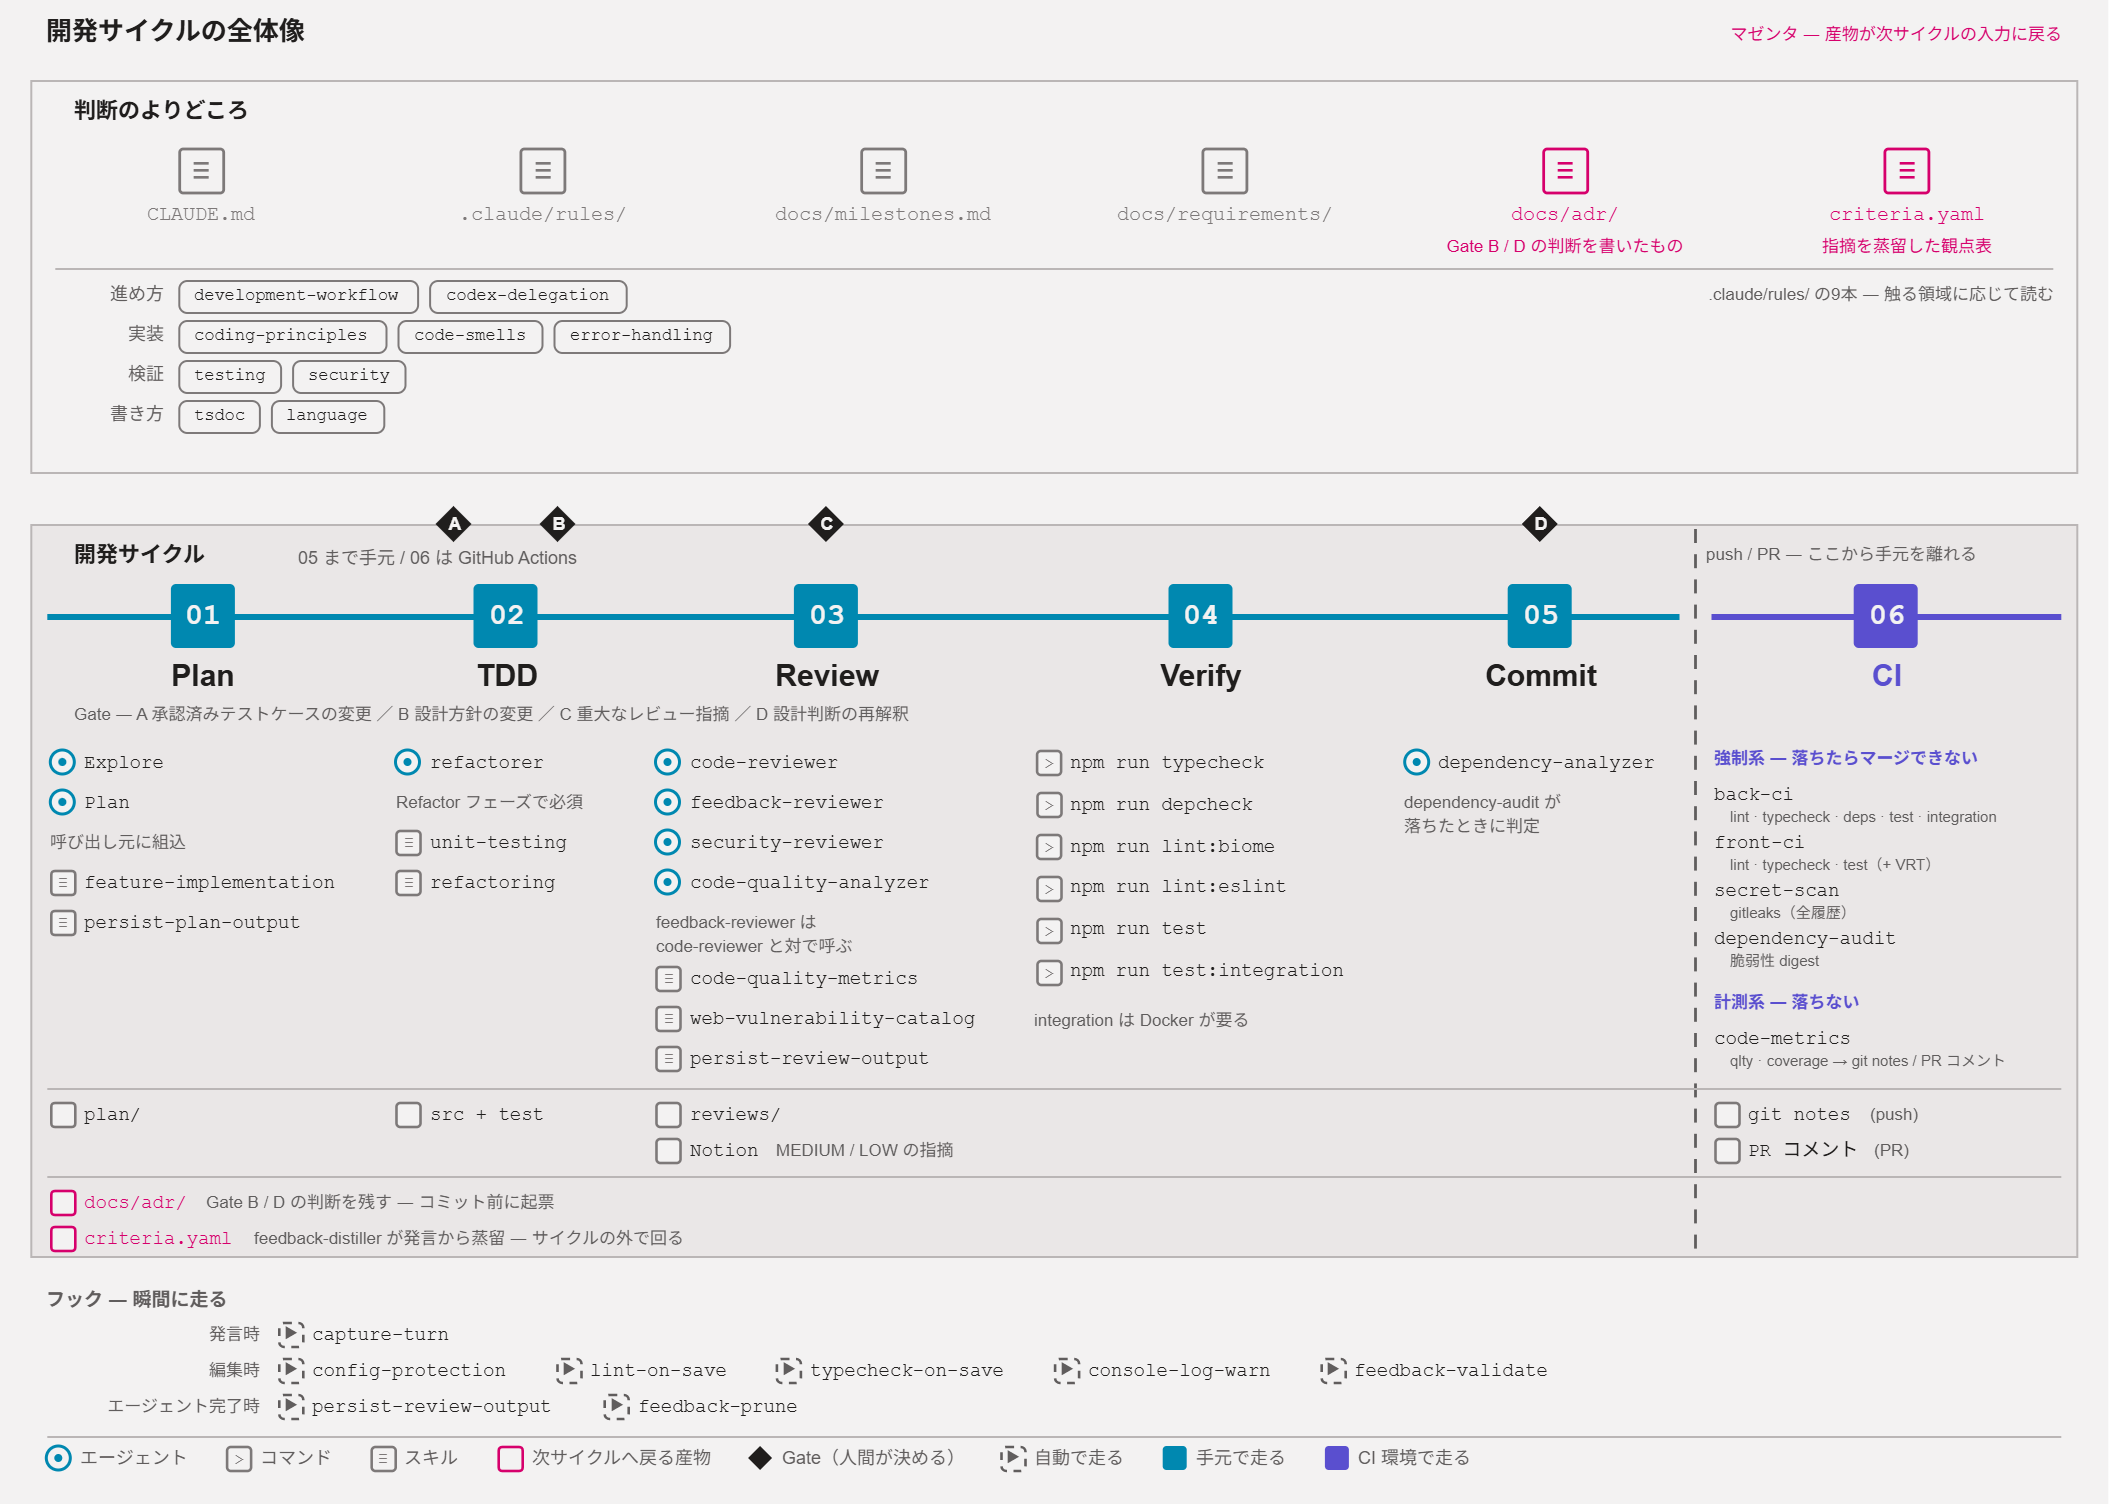
この図の読み方は以下の通りです。
- 上の枠が材料です。開発中に人間や Claude Code が繰り返し読むドキュメントで、
docs/adr/や.claude/rules/等々が並んでいます - 下の枠が実行です。
01 Planから06 CIまで、左から右に時間が流れます05 Commitまでは手元の環境、06 CIから先は GitHub Actions です。実行環境が変わるので、色を変えて破線で区切ってあります- 黒い菱形 A〜D は、ぼくが判断する場所です
- マゼンタの
docs/adr//criteria.yamlは上下に2つありますが、これは同じものです。判断や指摘が記録され、それが次の開発サイクルの材料に戻ります
この記事では、この図を左から順に追ったあと、図には描けなかった部分を詳解していきます。
このプロジェクトの憲法
#図の前提になっているルールが3つあります。
| ルール | 概要 |
|---|---|
| 行き先を決めてから、書き残す | 4段階のふるいで ADR / コード / 設計書 / 書かない に振り分ける |
| 書いて守らせるのではなく、書けなくする | 型で表現不能にすることを最優先にする |
| ぼくが判断する場面を決めておく | 判断を引き取る場所を工程の中に4箇所固定する |
行き先を決めてから、書き残す
#実装していると、コードの外に書き残しておきたいことが次々に出てきます。「なぜこの方式を選んだか」「全体はどう噛み合っているか」「この値の上限はいくつか」「デプロイはどう回すか」等々です。
以前はこれを片っ端から設計書に足していました。その結果、認証まわりの設計書が 3,000 行を超えたあたりでコードと設計書の内容が食い違いはじめます。どちらが正しいのか分からない。直すには2箇所を直さないといけない。そのうち設計書のほうを見なくなる。
そこで、書き残したいことが出てきたら先に置き場所を決めるようにしました。役割ごとの媒体はこうです。
| 役割 | 媒体 |
|---|---|
| WHAT(何を作るか) | 要件定義書 |
| WHY(なぜそう作るか) | ADR |
| HOW(どう作るか) | ソースコード(型・関数・zod schema) |
| VERIFY(正しく作られたか) | テストコード |
| OVERVIEW(俯瞰・統合) | 設計書 |
ただしこの表だけでは決まりません。たとえば「エラー処理はミドルウェアで一元化する」という内容は、そう決めた理由(WHY)でもあり、全体構成の一部(OVERVIEW)でもあります。同じ内容が ADR にも設計書にも行けてしまいます。
分かれ目を、決定を1つ切り取るか、全体の整合を1枚にまとめるかに設定しました。ADR は決定するたびに1ファイル増えるので、いま 124 本あります。設計書は「全体構成」「デプロイ手順」のように枚数が決まっていて、決定が増えると中身が追従します。
「この方式を選んだ理由」なら ADR、「全体がどう噛み合っているか」なら設計書へという具合です。
そのうえで、書き残したい内容ごとに4つの問いを上から順にかけて、最初に YES が出た行き先へ書き残したいことを送ります。
| 問い | YES の行き先 |
|---|---|
| Q1. それは「決定」か?(代替案・トレードオフがある) | ADR(1決定1ファイル) |
| Q2. コード / 型 / テスト / OpenAPI を読めば再生成できる事実か? | コードが真正ソース。ドキュメントには参照だけ残す |
| Q3. コードが変わるたびに変わる(揮発する)か? | ドキュメントには書かない。コード側に持たせるか、コードから自動生成する |
| Q4. 安定 ∧ コードの単一箇所から不可視か? | 設計書の領分 |
冒頭に挙げた4つを、この表に通してみます。「なぜこの方式を選んだか」は Q1 で ADR へ。「この値の上限はいくつか」は Q2 でコードへ。「全体はどう噛み合っているか」と「デプロイはどう回すか」は Q4 で設計書へ行きます。
この4つの問いで振り分けると、Q4 まで生き残るのは下記4類型と整理できました。
- 統合俯瞰(全体構成図)
- 横断の流儀(命名やログ項目の標準)
- 運用知識(デプロイ手順・runbook)
- ドメイン言語(用語集・コンテキストマップ)
いずれも「数ヶ月・多ファイルをまたいで真であり続ける」かつ「コードの1箇所を読んでも見えない」の交差領域です。
結果として、詳細設計書は書きません。ここでいう詳細設計書は、コードを書く前にクラス構成・関数のシグネチャ・項目定義・バリデーション規則・処理シーケンスを文章で決めておく、ウォーターフォールでいう「詳細設計」工程の成果物です。シグネチャや項目定義は型を読めば再生成できるので Q2 で、クラス構成や処理シーケンスはコードが変わるたびに変わるので Q3 で落ちます。
書いて守らせるのではなく、書けなくする
#規約を守らせる手段はいくつかありますが、いちばん優先するのは「型で表現不能にする」ことと決めています。ドキュメントに「こうしてください」と書いて守らせるのではなく、違反そのものを起こせなくする。
実際にそうしている箇所を2つ挙げます。
ID の偽造を、型と lint で禁止する
ユーザー ID のような識別子は、ただの string ではなく branded type にしています。
export const UserIdSchema = z
  .string()
  .min(1)
  .max(128)
  .regex(/^[A-Za-z0-9_-]+$/)
  .brand<"UserId">();

export type UserId = z.infer<typeof UserIdSchema>;

export const userId = (raw: string): UserId =>
  enforceInvariant(UserIdSchema, raw, "UserId");
.brand<"UserId">() が付いているので、生の string を UserId 型の引数に渡すとコンパイルエラーになります。UserId を作るには userId() を通すしかなく、そこで長さと文字種の検証が走ります。検証を通っていない値は、型のうえで存在できません。
ただし、型には抜け道があります。"anything" as UserId とキャストすれば、検証を通さずに UserId 型を名乗れます。
そこで、この抜け道を ESLint で塞くようにしました。
// eslint.config.mjs
const noAsBrandedScalarVo = {
  selector:
    "TSAsExpression[typeAnnotation.typeName.name=/^(UserId|BudgetId|SpendingQuadrant|BudgetQuadrant)$/]",
  message:
    "branded scalar / 列挙 VO への as キャストは型偽造の抜け道。生成は VO の factory 経由のみ。",
};
as UserId と書いた時点で lint が落ちます。「ID は必ず userId() で作ってください」とドキュメントに書く代わりに、型で塞ぎ、型の抜け道を lint で塞いでいます。
対応表の書き漏れを、コンパイルエラーにする
literal union で定義した値ごとに、対応する値を紐づける。こういう対応表をいくつか使っています。
type Status = "todo" | "doing" | "done";

const STATUS_SLUG = {
  todo: "to-do",
  doing: "in-progress",
  done: "done",
} as const satisfies Record<Status, string>;
末尾の satisfies Record<Status, string> により、union の全メンバーが揃っていないと型エラーになります。Status にメンバーを1つ足した瞬間、この表の更新漏れがビルド時に落ちます。レビューで気づく必要がありません。
どちらも共通しているのは、守られたかどうかを人間が確認していないことです。違反したらコンパイルか lint で落ちて、レビューまで届きません。
ぼくが判断する場面を決めておく
#規約と型で縛っても、実装中には必ず判断の要る場面が出てきます。そこでぼくが判断を引き取る場所を工程の中に4箇所配置しました。
図の黒い菱形 A〜D です。
| Gate | ぼくが判断すること |
|---|---|
| A | 承認済みテストケースを変えるかどうか |
| B | 実装中に発覚した設計方針をどう変えるか |
| C | 重大なレビュー指摘を、いま直すか先送りするか |
| D | 既存の ADR と現実のコードが食い違ったときの解釈 |
【第1部】1つの機能ができるまで
#この章では、1つの機能を作る間に前章の3つのルールがどう働くかを追っていきます。
図の下の枠を左から順にたどる形で、工程ごとに「何をして、どこで止まるか」を解説するつもりです。
Plan → TDD → Review → Verify → Commit → CI
       A B     C                 D
チェーンの下の A〜D が Gate の位置です。TDD で2回、Review と Commit で1回ずつ、判断がぼくに戻ってきます。
各工程の手順は feature-implementation スキルにまとめてあり、Claude Code は最初のファイルを書く前にこれを読み込みます。
1. 計画する
#まず、これから触る領域に関係する ADR を Claude Code に読ませます。とはいえ 124 本(現時点の数値)あるので、毎回全部渡すわけにはいきません。そこで CLAUDE.md に索引を持っています。
| 触る領域 | 必読 ADR | 関連設計書 |
|---|---|---|
| 認証 / 認可 | 0030, 0031, 0032, 0042 | authentication-design.md |
| ロギング / 監査ログ | 0009, 0033 §1.3, 0037 §3, 0042 | logging-monitoring.md |
| Hono ミドルウェア | 0037, 0038 | middleware-architecture.md |
| エラー戦略 | 0035, 0041, 0042, 0043, 0045, 0047 | error-handling-architecture.md |
Claude Code は着手前にこの表を引いて、該当する ADR だけを読みます。
次に、馴染みのない領域なら Explore エージェントで前例を探します。これは「既存の実装パターンを探す」ためのもので、狙いは実装の不整合を防ぐことです。
たとえば新しく xxxConfig.ts を作ろうとしたとき、すでに authConfig.ts が同じ構造で存在しているなら、それに倣うべきです。
放っておくとエージェントは毎回ゼロから「良い設計」を考えて、微妙に違う流儀を持ち込みます。
3ファイル以上に触る、アーキテクチャを変える、あるいは前例を探したら食い違うものが2つ出てきた。このどれかなら、さらに Plan エージェントを挟みます。
計画は、Plan エージェントを使ったかどうかに関わらず、.claude/docs/plan/ にスナップショットとして保存します。
このスナップショットは陳腐化する前提で置いています。実装が進めば計画とはズレるので、最新に保つ努力はしません。「当時どう段取りしたか」の記録として残すだけです。ここを「常に正しく保つドキュメント」にしようとすると、また二重管理が始まります。
なお、Explore と Plan は Claude Code に組み込まれているエージェントで、このプロジェクトで定義したものではありません。
Explore と Plan を呼ぶ条件を上記のように資材へ明記していますが、エージェントが毎回この通りに動くわけではありません。条件に当てはまっているのに Explore を飛ばして書き始める、ということは普通に起きます。ここに書いているのは「そう指示している」であって、「必ずそうなる」ではありません。
2. テストから書く
#テストの書き方はルールファイル testing.md が持っていて、エージェントはそれに従います。
Always follow a two-phase approach: define test cases → review → implement. Never implement tests before the user approves the test case list.
空のテストケースだけを先に書いて、ぼくにレビューを出す手順です。実際にはこういうものが提示されます。
describe("BudgetAmount", () => {
  // 正常系
  test("正の整数から生成できる", () => {});
  test("上限値ちょうどは生成できる", () => {});

  // 異常系
  test("0 以下は生成できない", () => {});
  test("上限を超える額は生成できない", () => {});
  test("小数を含む値は生成できない", () => {});

  // 境界
  test("上限 + 1 は生成できない", () => {});
});
中身は空で、test の説明文だけがある状態です。この状態で「この観点で合っていますか」と聞かれます。
ここで承認したテストケースをあとから変更するには、ぼくの承認が要ります。これが Gate A です。
承認なしで変更できるようにしていたときは、テストが通らない理由をフレームワークの都合と説明してテストケースごと削除する、ということが起きていました。そこで承認済みテストケースの変更は、理由の説明とセットで止めるようにしています。
Green のあとは refactorer エージェントを呼びます。Claude Code が実装したコードを読み、コードスメルを検出しリファクタリングを実施するサブエージェントです。
書いた本人には自分のコードの問題が見えにくいという話を聞き、実装直後に別のエージェントで見るようにしました。
3. レビューに出す
#観点ごとにエージェントを分けています。
| エージェント | 呼ぶ条件 |
|---|---|
code-reviewer |
3ファイル以上 or 100行以上の変更 |
feedback-reviewer |
code-reviewer を呼ぶときは必ず一緒に |
security-reviewer |
認証・認可・API・ユーザー入力・機密データ・DB クエリ・ファイルアップロード・決済・ログ出力・エラー処理に触れたとき |
code-quality-analyzer |
5ファイル以上 or 300行以上、または code-reviewer が構造的な懸念を挙げたとき |
feedback-reviewer だけ役割が違います。コードの一般的な品質ではなく、過去にぼく自身が指摘した観点に照らして差分を見るエージェントです。観点がどこから来るかは第2部で書きます。
これらエージェントのレビュー結果は自動で保存されます。レビュー系エージェントが完了すると PostToolUse フックが発火します。このフックで persist-review-output.py が出力の全文を .claude/docs/reviews/ に書き出します。
指摘のうち MEDIUM / LOW は、Notion のバックログに積みます。HIGH / CRITICAL は次の Gate C で扱います。
Gate ― 人間が判断する
#前章で挙げた4つの Gate が、それぞれどこで発火するかをまとめます。
| Gate | 発火する工程 | 発火条件 | ぼくが決めること |
|---|---|---|---|
| A | TDD | 承認済みのテストケースを変えようとした | 変更を認めるか |
| B | TDD | 実装してみて設計方針を変える必要が出た | 方針を変えるか。変えるなら ADR を書いてから進める |
| C | Review | レビューが HIGH / CRITICAL を報告した | いま直す / 理由つきで先送りする / リスクを受容する |
| D | Commit の直前 | 書いたコードが既存の ADR と食い違っている | 解釈を決め、ADR を書いてからコミットする |
B と D は、いずれも ADR をコミット前に書くことにしています。
ADR には「エラー処理は errorMiddleware で行う」と書いてありました。リクエスト処理の途中に挟むミドルウェアで、ハンドラが投げた例外を捕まえる想定です。ところが実装してみると、バックエンドに使っている Hono では、ミドルウェアの中で try/catch してもハンドラの例外を捕まえられませんでした。フレームワークが内部で例外を処理してしまうためです。捕まえるには、Hono が用意している app.onError() という別の登録口を使う必要がありました。
ここで ADR の「errorMiddleware」を「app.onError のことだ」と読み替えて進めることもできます。ただそれをやると、実装に存在しない仕組みが ADR に書かれたまま残ります。そこで新しい ADR を書いて、この技術制約と、以降は「errorMiddleware」を app.onError のハンドラとして読む、という解釈を残しました。元の ADR の本文は書き換えていません。
4. 検証する
#コミット前に、エージェントが触ったパッケージで4つを通します。
npm run typecheck
npm run depcheck
npm run lint:biome
npm run lint:eslint
npm run test
npm run test:integration
憲法の2つ目で書いた仕掛けが実際に落ちるのは、ここです。as UserId のキャストは lint で、対応表の書き漏れは typecheck で落ちます。エージェントが規約を読み落としていても、違反はこの段階で止まります。
5. コミットする
#コミットは1つの機能で1回ではなく、区切りがつくたびに積みます。それぞれ /commit を実行して Conventional Commits 形式のメッセージを作るようにしました。
Gate B / D で設計判断が動いていた場合、その判断を含むコミットより前に ADR が書かれています。図で docs/adr/ に「コミット前に起票」と注記したのはそのためです。
ADR はコミットの成果物ではなく、コミットの前提条件という位置づけにしました。
6. push して CI に渡す
#ここで実行環境が変わります。図で色が変わっているところです。
CI は、落ちたらマージできないものと、落ちないものに分けています。
| 系統 | ワークフロー | 中身 | 挙動 |
|---|---|---|---|
| 強制系 | back-ci |
lint / typecheck / 依存関係 / 単体テスト / 統合テスト | 落とす |
front-ci |
lint / typecheck / テスト(VRT 含む) | 落とす | |
secret-scan |
gitleaks による全履歴の秘密情報スキャン | 落とす | |
dependency-audit |
依存の脆弱性の判定漏れ・古い判断の検出 | 落とす | |
| 計測系 | code-metrics |
qlty メトリクス / カバレッジ | 落とさない。git notes に蓄積し、PR に差分コメント |
dependency-audit が落ちたときは ローカル環境で dependency-analyzer エージェントを呼びます。
脆弱な関数に実際に到達するか、受容してよいかという、機械では決められない2点を判断するサブエージェントです。
工程の合間で、勝手に走るもの ― フック
#ここまでの工程とは別に、決まった瞬間に自動で走るものがあります。
| 瞬間 | フック | やること |
|---|---|---|
| ぼくが発言したとき | capture-turn |
発言を逐語で索引に残す(第2部で使う) |
| ファイルを編集したとき | config-protection |
lint / formatter の設定ファイルへの編集をブロックする |
lint-on-save / typecheck-on-save |
編集したファイルを整形し、型検査する | |
console-log-warn |
残った console.log を警告する |
|
feedback-validate |
観点表への手編集を検知する(第2部参照) | |
| エージェントが完了したとき | persist-review-output |
レビュー出力を保存する |
feedback-prune |
使われなくなった観点を観点表から落とす(第2部参照) |
エージェントがやろうと思ってやるのではなく、その瞬間が来たら実行される仕組みです。
なお、config-protection だけ性格が違います。他は記録か整形ですが、これは編集そのものを止めます。
lint の設定を緩めれば規約違反は消えるので、その手を最初から使えないようにしました。
【第2部】どの情報を、どこに置いているか
#ここまでが冒頭の図の範囲です。図には「何があるか」までを描きました。ここからは、それぞれに何を書いていて、なぜそこに置いたのかを解説していきます。
Claude Code に常に読ませておける量には限りがあります。全部を CLAUDE.md やルールに書くと、読み込むだけで文脈が埋まり、肝心の指示が埋もれます。
そこで、情報ごとにいつ読まれるべきかを決めて、置き場所を分けました。
| 置き場 | 読まれるタイミング | 置いているもの |
|---|---|---|
CLAUDE.md / .claude/rules/ |
常に | 索引、常に効く制約と事実 |
.claude/skills/ |
該当する作業のときだけ | 手順、プロジェクト固有の方法論 |
| lint / 依存検査 | 機械が常に | 守らせたい規約 |
docs/ |
索引から引いたときだけ | ADR、設計書、要件、マイルストーン、技術ノート |
.claude/agents/ |
呼ばれたとき | 役割、不変条件、出力の形 |
| スクリプト | エージェントが結果を読む | 計算 |
criteria.yaml |
レビューのとき | ぼくの過去の指摘 |
フックも置き場のひとつですが、第1部で書いたのでここでは省きます。
憲法の1つ目で、書き残したいことを ADR / コード / 設計書 / 書かない に振り分ける4つの問いを書きました。Claude Code 向けの資材にも、同じ問いを当てています。
そのため、コードや型から再構成できることは書かない。コードが変わるたびに変わることも書きません。
常に効かせるもの ― CLAUDE.md と .claude/rules/
#CLAUDE.md は149行で、中心は第1部で出てきた「触る領域 → 必読 ADR」の索引です。ADR の中身は書かず、引き方だけを持たせています。
ほかには、本番環境や機密の所在といった、どの作業でも踏み越えてはいけない境界を書いています。
一方、.claude/rules/ には9本のファイルがあり、どれも 16〜75 行です。
| ファイル | 持っているもの |
|---|---|
development-workflow.md |
工程の順序と、どの工程でも効く制約 |
coding-principles.md |
戻り型注釈の必須化など、全ファイルに効く原則 |
code-smells.md |
過去のレビューで指摘が多かったコードスメル7つ |
error-handling.md |
エラーを例外で投げてよい5つの場面(それ以外は戻り値で返すというルール) |
security.md |
リソースの所有者検証など、コードを書くときに常に守るセキュリティ上のガードレール |
testing.md |
本番コード側の禁止と、テスト環境の事実 |
tsdoc.md |
コメントの書き方のうち、既存コードを真似しても決まらない事項(ADRドキュメント内 の内部記号を書かない、など) |
language.md |
識別子・文字列・コメントを何語で書くか |
codex-delegation.md |
Codex に相談してよい条件(最近はほとんど使っていません) |
ルールに置くのは、次の3つです。
- 事実
- 禁止事項
- 真正ソースへの道案内
それ以外はルールに記載せず、それぞれの置き場に任せています。
| ルールに書かないもの | 置き場 | 例 |
|---|---|---|
| 手順 | スキル | 工程の進め方(feature-implementation) |
| ADR に書いてあること | ADR | レイヤー別の複雑度の閾値 |
| コードを読めば分かること | 実際のコード(真正ソース) | エラー型の作り方、コメントの書式 |
コードを真正ソースにしているものは、Claude Code に近くのファイルを真似させています。
該当する作業のときだけ読み込むもの ― .claude/skills/
#スキルは説明文で示した作業に当てはまったときだけ読み込まれます。常には読み込まれないので、手順のように長くなるものを置いています。
中身は2種類に分かれます。
| 種類 | 書いていること | 主に使う側 | 例 |
|---|---|---|---|
| 手順 | 「この作業は毎回この形でやる」という進め方 | Claude Code 本体 | feature-implementation / persist-plan-output / persist-review-output / notion-task |
extract-learning / consulting-codex / observe-metrics |
|||
| 方法論 | 一般論を、このプロジェクト向けに上書きする箇所だけ | サブエージェント | refactoring / unit-testing / web-vulnerability-catalog |
ルールとスキルのどちらに置くか
#ひとつの決まりをルールとスキルのどちらに書くかで迷うことがあります。たとえばテストに関する決まりは、テストのスキルに書くのが自然に見えます。
ただ、2つは Claude Code に読み込まれるタイミングが違うので、置く場所を間違えると必要な場面で Claude Code の目に入りません。
| 種類 | 読み込まれるタイミング | 例 |
|---|---|---|
| ルール | どんな作業をしていても常に | testing.md |
| スキル | スキルの説明文に書いた作業に当てはまったときだけ | unit-testing(テストを書くときだけ) |
そこで、どちらに置くかは次の3つの問いで決めました。
- 近くのファイルを真似すれば同じように書けるか → 書けるなら、どちらにも書かない
- その決まりが破られるのは、スキルが読み込まれている作業の最中か → そうでないなら、ルールに置く
- 破られても、テストや lint で気づけないか → 気づけないなら、ルールに置く
例えばテストに関する決まりを2つ、この問いに当てるとこうなります。
| 決まり | 破られるのはいつか | テストのスキルは読み込まれているか | 置き場 |
|---|---|---|---|
| 本番コードにテスト都合の分岐を足さない | 本番コードを書いている最中 | いない | ルール(testing.md) |
| エラーのメッセージ文言でアサートしない | テストを書いている最中 | いる | スキル(unit-testing) |
どちらもテストの決まりですが、置き場を分けました。
「本番コードにテスト都合の分岐を足さない」が破られるのは、本番コードを書いている最中です。そのときテストのスキルは読み込まれていないので、スキルに書いても Claude Code の目に入りません。そこでルールに置きました。
文書に書かず、検査に持たせるもの
#lint や依存検査で気づけるものは、ルールには書かず、検査の設定として置いています。
憲法の2つ目に書いた「書けなくする」を、型で表現できないものに広げた形です。
依存方向 ― dependency-cruiser(15ルール)
| ルール | 禁止していること |
|---|---|
domain-no-infrastructure |
Domain から Infrastructure への依存 |
application-no-infrastructure |
Application から Infrastructure への依存 |
hono-only-in-interface-http |
Hono を HTTP 層の外で使うこと |
no-cross-context-domain |
コンテキストをまたいだ Domain の参照 |
ほかに循環依存・孤立ファイル・Port 層の依存制約など、あわせて15本。ADR 0002 で決めたレイヤー構造を、そのままルールに落としてあります。
戻り値の型 ― 自作の ESLint ルール
UseCase と Port(Repository の interface)の戻り値の型が Result になっているかを検査します。
既製の ESLint ルールには、戻り値の型を特定の型に限定するものがなかったので自分で書きました。
依存方向の検査も戻り値の型の検査も、違反したコードは検査で落ちます。そのとき Claude Code がルールやスキルを読み込んでいたかどうかは関係ありません。だから、同じ決まりをルールファイルに書いておく必要もありません。
索引から引くもの ― docs/
#docs/ は Claude Code が常には読まず、必要なときに CLAUDE.md の索引から辿って開く場所です。中身は5つに分かれます。
| 置き場 | 中身 | どこから引くか |
|---|---|---|
docs/adr/ |
決定の記録 | 索引の「触る領域 → 必読 ADR」 |
docs/design/ |
設計書(全体構成、デプロイ手順など) | 同じ索引の「関連設計書」 |
docs/requirements/ |
要件定義書 | 何を作るかを確かめるとき |
docs/milestones.md |
Phase の定義と進捗 | 索引の「Phase の現在地」 |
docs/learning/ |
技術の学習ノート | エージェント定義やスキルから名指しで |
ADR と設計書に何を書くかは、憲法の1つ目で書いたとおりです。ここでは docs/learning/ について書きます。
docs/learning/ は、もともとは Claude Code と作業する中でぼくが理解した技術の仕組みを、あとで読み返せるように残しておく学習ノートの置き場です。
そのうち Fowler のリファクタリングのカタログは、refactorer エージェントがスメルや手法の名前を確かめるときにも引いています。Claude はスメル名や手法の手順をもともと一般知識として知っているので、毎回は読ませず、名前や手順が出てこないときだけ開くように書いています。
方法論のうち一般論として通用するものは、このように書籍等から借りています。置き場は学習ノートかスキルで、出典は次のとおりです。
| 知識 | 出典 |
|---|---|
docs/learning/refactoring-smells-and-techniques.md |
Martin Fowler『リファクタリング(第2版): 既存のコードを安全に改善する』オーム社 |
unit-testing |
Vladimir Khorikov『単体テストの考え方/使い方』 |
web-vulnerability-catalog |
IPA「安全なウェブサイトの作り方 改訂第7版」(2021-03-31) |
呼ばれたときだけ効くもの ― サブエージェント
#ここでいうエージェントは、Claude Code 本体から呼び出される別のエージェント(サブエージェント)です。プロジェクトで定義しているものは次のとおりです。
| エージェント | 責務 | 参照する方法論 |
|---|---|---|
code-reviewer |
品質・型安全性・保守性 | unit-testing / code-quality-metrics / refactoring |
feedback-reviewer |
ぼくが過去に指摘した観点に照らす | criteria.yaml(観点表) |
security-reviewer |
脆弱性検出 | web-vulnerability-catalog |
code-quality-analyzer |
定量分析・優先順位付け | scripts/metrics-digest.py(計測スクリプト) |
refactorer |
振る舞いを変えない構造改善 | refactoring / simplify / docs/learning/ のカタログ |
dependency-analyzer |
依存脆弱性の到達性と受容の判定 | scripts/audit-digest.mjs の出力 |
右端の列のとおり、エージェント定義そのものには方法論を書いていません。例えば refactorer の定義は、こう始まります。
スメルの分類と手法の手順は一般知識と
docs/learning/refactoring-smells-and-techniques.md、その一般論がこのプロジェクトで通らない箇所はrefactoringスキルが持つ。
エージェント定義に置いているのは「役割」と「手順」と「してはいけないこと」で、やり方の知識はスキルとカタログに切り出しました。
いつ呼ぶか(何ファイル以上の変更で呼ぶか、など)も各エージェントの description にだけ書き、ルールには重複させていません。
実例① ― code-reviewer は、どこを見て判断しているか
code-reviewer は、レビューの途中でいくつもの置き場を参照します。エージェント定義には、判断の種類ごとにどこを見るかの対応表を持たせました。
| 判断する対象 | 見る場所 |
|---|---|
| 関数やファイルの複雑度の閾値 | ADR(レイヤー別の閾値) |
| エラーの扱い(例外か戻り値か) | ADR |
| ログやエラーメッセージに個人情報を出さない | ルール(security.md) |
| コメントの書き方 | 近くのファイルの実物と、ルール(tsdoc.md) |
そのうえで、参照のしかたを2つ決めています。
- 閾値などの値はエージェント定義に書き写さず、出典を引用する。書き写すと、ADR を改訂したときに追随しないため
- 参照先どうしが食い違ったら、ADR → コードのコメント → ルールの順に優先する
サーブエージェントが利用するスキルは、必要に応じて都度読み込むようにしました。
| スキル | 読み込む条件 |
|---|---|
unit-testing |
差分にテストファイルが含まれる |
code-quality-metrics |
指摘に数値の裏付けが要る |
refactoring |
重大な指摘の修正案を書く直前 |
逆に、lint が全件検出するもの(any の使用、未使用の import など)は、チェックリストから外しています。
目で探すものではなく、機械に任せるものとして分けました。
実例② ― dependency-analyzer は、何を引き受けていないか
CI の dependency-audit が落ちたときに呼ぶエージェントです。定義の冒頭にはこう書いています。
あなたの役割は脆弱性を 検出する ことではありません。検出と、機械的に導出できる解釈(依存経路、dev/prod、CVSS の分解、修正手段)は
scripts/audit-digest.mjsが既に済ませています。あなたが引き受けるのは digest が原理的に答えられない 2 点 だけです。
脆弱性の検出と、機械的に出せる情報(どの依存から入ってきたか、本番に載るか、どう直せるか)はスクリプトが先に出しています。
エージェントが受け持つのは次の2点です。
- 到達可能性 ― 脆弱な関数に、このコードベースから実際に到達するか
- 受容の是非 ― 直すか、受け入れるか、先送りするか
到達可能性は次の順で調べるように書いています。
- 依存の起点が開発用か本番用かを見る。
- 本番用なら、自分のコードがその依存を直接使っているかを grep で見る。
- 脆弱性の対象になっている機能を、自分のコードが通るかを読む。たとえば「Hono の CORS ミドルウェアに ReDoS」なら、CORS ミドルウェアを使っているかを確かめる。
なお、脆弱性の重要度(severity)をそのまま優先度として扱わないようにしました。
さらに、エージェント定義にはやらないことも書いています。
- スクリプトの出力を、自分で計算し直さない
- 判断の台帳に自分で書き込まない。貼り付けられる文面を返すところまで。
- 直せるものについては、到達可能性を調べない。直せば済むので。
実例①②に書いたのは、エージェント定義に書いている指示です。
フックなどで強制しているわけではないので、たとえば dependency-analyzer が台帳に書き込むことも技術的にはできます。
計算させないもの ― スクリプト
#計算や機械的に出せる情報はエージェントに計算させず、スクリプトに持たせています。
例えば code-quality-analyzer は、scripts/metrics-digest.py の結果を読みます。dependency-analyzer は、scripts/audit-digest.mjs が出した脆弱性の一覧を読みます。
スクリプトに持たせたのは、テストを書いたうえで出力が正しいかを機械的に確かめられるからです。
値はスクリプトが出し、エージェントにはその値が何を意味するかの判断だけを任せる、という分担です。
ぼくの指摘を溜めるもの ― 観点表
#第1部に出てきた Review 工程で feedback-reviewer が照らす「観点」は、.claude/feedback/criteria.yaml という観点表にあります。
中身は、ぼくがエージェントに対して過去にした指摘をパターンに蒸留したものです。例えば1項目はこんな形です。
- id: corrections:260816-115935-1
  pattern: 変更した用語・値・コマンド・手順を、同じものを記述する他資材(他 ADR / plan / CLAUDE.md / rules / 設定ファイル)へ波及させず、旧記述を残したまま提示する
  scope: docs/**/*.md, .claude/**/*.md, CLAUDE.md
  detection_hint: 差分で置き換えた用語・数値・コマンド文字列を rg でリポジトリ全体に検索し、ヒットした他ファイルが同じ差分に含まれているかを照合する
  occurrence: 10
ぼくの発言が観点表の項目になり、レビューで使われ、役目を終えて消えるまでの流れはこうです。
capture-turnフックが、ぼくの発言を逐語で索引に残すfeedback-distillerエージェントが蓄積された発言を読み、矯正にあたるものを抽出して、既存の項目と同種かを分類する- 昇格候補をぼくに提示し、承認した分だけ観点表に書く
feedback-reviewerが、Review 工程でコード差分を観点表に照らす- 何度照らしても違反が見つからない項目は、
feedback-pruneフックが観点表から落とす。
なお、この蒸留は開発サイクルの中では回しません。
セッションの冒頭で feedback-nudge フックが未蒸留の発言があると知らせてきたときにまとめて回しています。
ADR や規約が「決めたこと」を残す仕組みだとすると、こちらは「言ったのに守られなかったこと」を残す仕組みです。
おわりに
#はじめにで書いたとおり、この形も通過点だと思います。実際、第1部で書いた Gate は、この記事を書いている間に見直しました。
Gate のたびにぼくの判断待ちで実装が止まり、1つのタスクが何度も止まっていたためです。この記事では、見直す前の形のまま書いています。
ほかにも、まだ答えが出ていないことがあります。
- ぼくがタスクのボトルネックになっている:いまは勉強の意味も込めて、成果物に全部目を通しています。そのぶん、タスクがぼくのところで止まります。
- チームで開発するときの仕組みがない:ここまでの仕組みは、ぼく1人での開発を前提に作っています。複数人で一緒に開発する場面での仕組みは、まだ整えられていないと感じています。
- 要求から実装までが、ひと続きになっていない:この記事で書いたのは、要件が決まったあとの開発プロセスです。その上流で顧客の要望・要求を整理して開発の要件に落とし込み、設計して実装するまでを通しでつなぐ仕組みは、まだ整備できていないと感じています。
どれもすぐに答えが出るものではないので、今後も自分で試行錯誤しながら、少しずつ整備していきたいと思います。